
前阵子帮朋友看了一台 1 核 2G 的小机器。他那个站白天好好的,MySQL 偏偏总在半夜停,宝塔里点一下启动又能恢复,过两天继续来。
他一开始怀疑数据库坏了,准备备份重装。我说先别折腾,MySQL 每次都能正常拉起来,就先看看是不是系统内存不够,把它杀了。这个比猜配置文件靠谱。
先看 OOM,不要只盯着“已停止”
面板上的“mysqld 已停止”只告诉你结果,不告诉你原因。直接上服务器翻内核日志:
dmesg -T | grep -Ei 'out of memory|killed process|oom' | tail -n 20有些系统不让普通用户读 dmesg,或者重启后旧日志没了,可以再查 journal:
journalctl -k --since "7 days ago" | grep -Ei 'out of memory|killed process|oom' | tail -n 20那台机器的日志里就有这么几行:
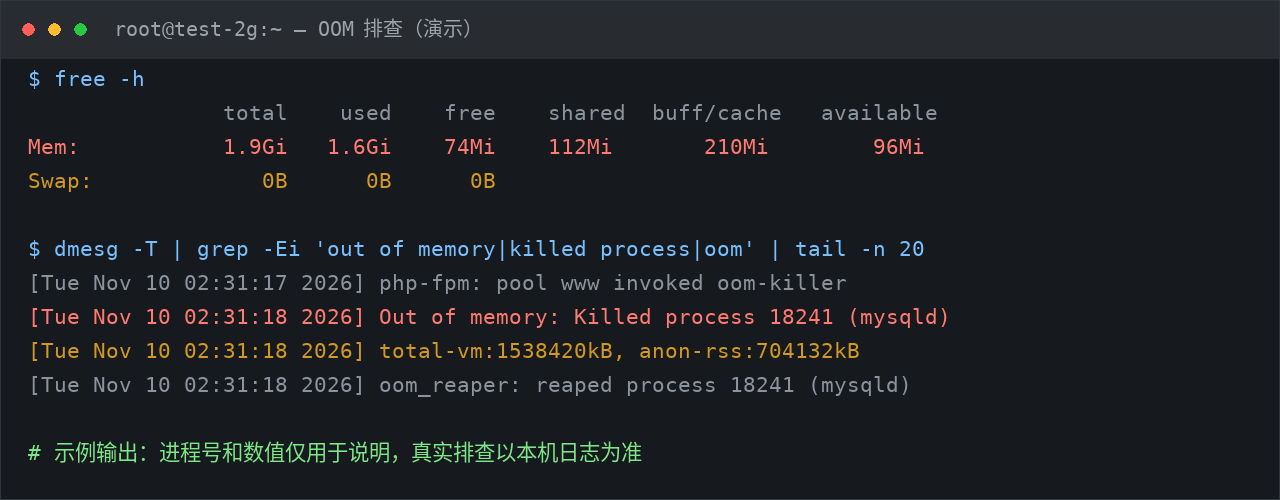
看到 Out of memory: Killed process ... (mysqld),事情就清楚一半了。不是 MySQL 自己想停,是内存耗尽以后,系统挑了个占用大的进程下手。这时候去修数据表、反复重装 MySQL,方向都反了。
如果两条命令都没有 OOM,再去看 MySQL 自己的错误日志。宝塔一般在 /www/server/data/ 下的 .err 文件,发行版包安装的常见位置是 /var/log/mysql/error.log。别把所有“数据库停止”都当成同一种病。
内存到底被谁吃了
先看总览和进程排行:
free -h
ps -eo pid,comm,rss,%mem --sort=-rss | head -n 15
free 那一列小,不一定就是坏事,Linux 会拿空闲内存做缓存。真正要盯的是 available,也就是现在还能拿来分给程序的大致余量。
小机器上最常见的组合是:MySQL 的 buffer pool 配大了,PHP-FPM 子进程又给多了,再撞上一个备份或定时任务。单看谁都挺正常,凑到一起就爆。
PHP-FPM 每个子进程吃多少,别上网抄一个数,自己在机器上量。下面这条可以粗略算一下当前池进程的平均 RSS:
ps -eo rss,args | awk '/php-fpm: pool/ && !/awk/ {sum += $1; n++} END {if (n) printf "平均 %.1f MB,共 %d 个池进程n", sum/n/1024, n}'比如平均 50 MB,你给他留 400 MB,那就最多放 8 个左右的子进程,还得把主进程和波动算进去。pm.max_children 写 20,理论上光 PHP 就可能准备吃掉 1G,剩下的再给 MySQL 和系统显然不够。
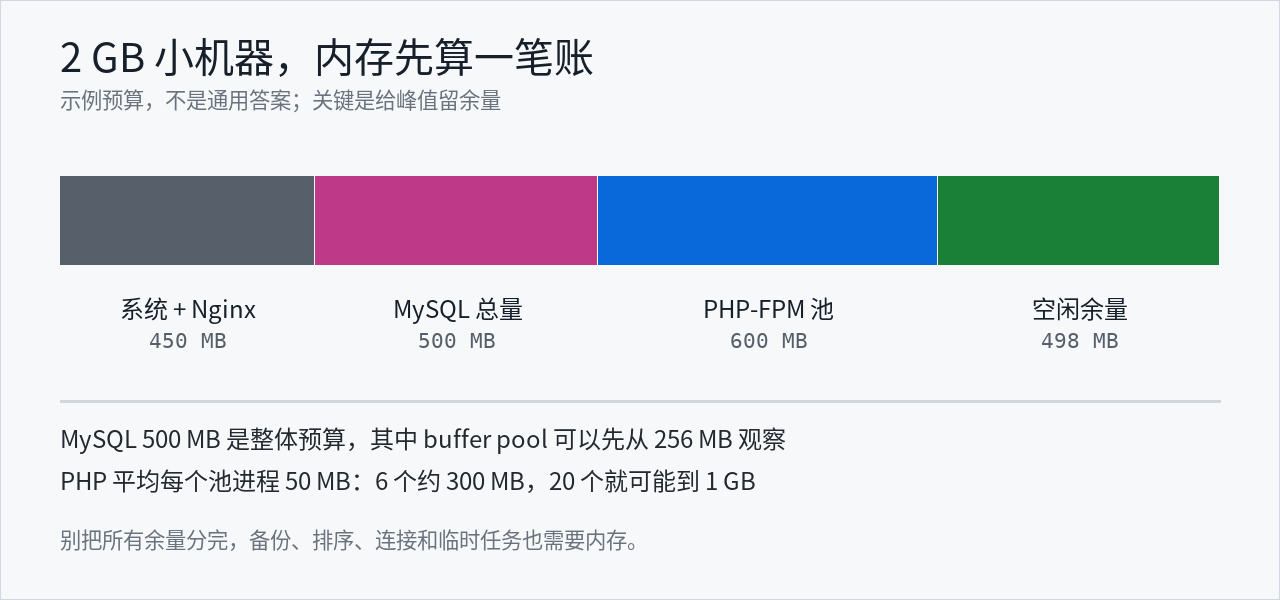
上面这个图只是算账的方法,不是让你照抄数字。还有一句容易漏掉:innodb_buffer_pool_size 只是 InnoDB 的缓冲池,不等于 MySQL 全部内存,连接、排序和临时表还会继续吃。
小内存机器,我会先动这三处
第一处是 MySQL 缓冲池。总共才 2G,配置里还写着 1G,就先往下降。小站可以先从 256M 观察,不是所有人都该填这个数,数据量大的站另说:
[mysqld]
innodb_buffer_pool_size = 256M
改之前备份原配置,改完先检查错误日志,再重启。别顺手把一堆所谓“MySQL 万能优化参数”全粘进去,到时候是哪一项起作用、哪一项惹事都不知道。
第二处是 PHP-FPM。按实际内存算 max_children,不要拿 8G 机器的教程往 2G 上套。下面只是前面那个例子的量级:
pm = dynamic
pm.max_children = 6
pm.start_servers = 2
pm.min_spare_servers = 1
pm.max_spare_servers = 3
pm.max_requests = 300
max_requests 能让子进程处理一定请求后重建,对有轻微内存泄漏的老代码有点用,但它不是治泄漏的药。改完记得用对应 PHP 版本的 php-fpm -t 检查配置,再重载服务。
第三处是半夜的定时任务。那台机器每次都在两点半左右出事,最后发现是备份任务一上来,压缩和读取文件把剩下的余量也吃掉了:
crontab -l
ls -l /etc/cron.d
用面板的也顺手看一眼面板计划任务,它不一定都在 root 的 crontab 里。备份、杀毒扫描、日志切割没必要挤在同一分钟,错开就行。
swap 能兜底,但别把它当内存用
1 核 2G 的小机器,我一般还是会留 1G swap。真撞上短时高峰,它可能让机器慢一点,但总比直接杀 MySQL 强。不过要是长期有大量内存换进换出,网站已经卡得没法用了,那就该减服务或升配置,不是继续加 swap。
# 先确认现在有没有,有的话别重复添加
swapon --show

# 没有 swap 时,下面是一个 1G 的示例
fallocate -l 1G /swapfile
chmod 600 /swapfile
mkswap /swapfile
swapon /swapfile
要开机自动挂载,再把 /swapfile none swap sw 0 0 写进 /etc/fstab。写之前先备份,而且确认里面没有已有的 swapfile 行。面板已经提供 swap 设置的,直接用面板也行,别两边重复搞。
最后那台机器是怎么处理的
查完以后没什么高深原因:buffer pool 给了 1G,PHP-FPM 允许 20 个子进程,没有 swap,两点半还跑整站备份。平时访问少看不出,备份一上来就顶满。
我把缓冲池先降到 256M,PHP 子进程压到 6 个,补了 1G swap,再把备份时间往后挪了一个半小时。观察一周没再掉,半夜内存最高那次也没再触发 OOM。
这里真正有用的不是“256M”或者“6 个”这两个数字,而是先找到 Out of memory 那行日志。没有这行,就先别乱抄 OOM 优化教程。
以后再遇到 MySQL 莫名其妙停,别只发一张“启动失败”的截图。把 dmesg、free -h 和 MySQL 错误日志最后几十行一起贴出来,基本就有排查方向了。





没有回复内容